Suno Speech: озвучка текста с интонацией и фоновой музыкой
100 ₽ в подарок при регистрации
Промпт
Scene: a dark minimalist home recording studio at night, deep near-black background #0A0A0F, warm amber #F5A623 accent light. Main object: a vintage studio microphone on the left; from it a glowing amber voice waveform flows to the right and smoothly merges with soft flowing musical sound waves into one single luminous ribbon of sound. Details: subtle acoustic foam panels in deep shadow, a pair of headphones resting on the desk, fine glowing particles along the ribbon, glass and metal textures, photorealistic. Composition: 16:9 wide, microphone left of center, the merged sound ribbon crossing to the right, clean negative space, high contrast, cinematic warm mood, amber and black palette only. Constraints: absolutely NO text, NO letters, NO logos, NO numbers, NO watermark, NO people, NO human figures, NO music notes with letters. Use: blog article cover about an AI model that voices text with intonation and background music as one track.
Главное:
- Suno Speech — модель Suno, которая делает речь и музыку одной дорожкой; разработчик открыл её бету 1 октября 2026 года.
- Два режима: по описанию сцены модель сама пишет текст, а в режиме «Свой текст» озвучивает ваш сценарий до 3000 символов.
- В режиме «Свой текст» настраиваются подача, голос, разнообразие и фоновая музыка, которую можно включить или выключить.
- Цена фиксированная за запрос, и за один запуск приходят две дорожки.
- Оплата в рублях через СБП, без подписки и зарубежной карты.
Suno Speech — это нейросеть для озвучки от создателей Suno: она озвучивает текст голосом с интонацией и сразу кладёт под него фоновую музыку, так что на выходе получается готовая дорожка, а не голая речь. Ниже разберём, чем Suno Speech отличается от обычного синтеза речи, как работают два её режима, что значит каждая настройка, сколько стоит запрос в рублях, и дадим готовый рецепт озвучки в стиле радиоэфира, который можно повторить за пару минут.
Что такое Suno Speech и чем она отличается от обычной озвучки
Suno Speech — модель, которая генерирует голос и музыку вместе, одной цельной дорожкой, а не накладывает подложку на готовую речь. Так её описывает сама компания в анонсе Speech (beta) от 1 октября 2026 года: разработчик называет её первой аудиомоделью, которая создаёт речь и музыку как единое целое.
Обычная озвучка устроена иначе. Сервис синтеза речи выдаёт голос без фона, а музыку вы ищете отдельно, подбираете громкость и сводите в редакторе так, чтобы подложка не забивала слова. Suno Speech убирает этот шаг: голос и подложка появляются в одной генерации, поэтому суно озвучка выходит готовым фрагментом передачи или ролика, а не диктором поверх случайного трека.
По словам разработчика, перед запуском модель месяц тестировала небольшая группа пользователей, после чего бету открыли всем — в веб-версии и в мобильном приложении, как отмечает статья о Suno в Википедии. В анонсе компания перечисляет и сценарии, ради которых делала Speech: драматичное чтение сообщений друзей, голосовые заметки с эпичной музыкой, медитации, стихи, мотивирующие речи и сказки на ночь.
В IskraGen Suno Speech — отдельная карточка в категории «Озвучка», а не режим музыкальной модели Suno. Это важно, когда ищете её в каталоге: песни с вокалом делает Suno, а речь с подложкой — Suno Speech. Открыть модель можно на её странице в каталоге или сразу в Студии.
Кому это пригодится на практике:
- Авторам коротких роликов, которым нужна подводка или закадровый текст с настроением.
- Тем, кто делает подкасты и хочет заставку или отбивку с голосом ведущего.
- Тем, кто записывает поздравления, сказки или медитации и не хочет искать музыку отдельно.
- Маркетологам, которым нужен черновик аудиоролика до записи с живым диктором.
Два режима Suno Speech: по описанию и свой текст
У Suno Speech два режима: в первом вы описываете сцену и модель сама пишет текст, во втором она озвучивает ваш готовый сценарий. Оба режима принимают до 3000 символов, но дальше устроены по-разному, и выбор зависит от того, есть ли у вас уже готовые слова.
Режим «По описанию». Вы пишете, кто говорит, о чём и с каким настроением, а модель сама придумывает реплику и озвучивает её. Дополнительных настроек здесь нет: всё, что хотите получить, — голос, интонацию, характер музыки — вы описываете в одном поле. Режим подходит, когда точного текста ещё нет и нужен быстрый набросок: заставка для подкаста, шуточное поздравление, атмосферная подводка к ролику. Пример описания: «Уставший, но добрый смотритель маяка рассказывает детям сказку о ночном шторме, тихий голос, за окном шумит море, мягкая музыка».
Режим «Свой текст». Здесь Suno Speech озвучивает ваш готовый текст, тоже до 3000 символов. Это режим для готовых сценариев: закадровый текст ролика, вступление к выпуску, рекламная подводка, стихотворение. Помимо самого текста, в нём есть четыре настройки — подача, разнообразие, голос и фоновая музыка, — и они разобраны в следующем разделе. В справке разработчика этот режим описан так же: текст в поле сценария, а тон, темп, настроение и обстановка — в отдельном поле, как сказано в статье What is Suno Speech (beta).
Как выбрать режим:
- Нужно озвучить свой готовый текст — берите «Свой текст».
- Нужна идея и атмосфера, а формулировки не важны — подойдёт «По описанию».
- Хотите озвучку текста с музыкой и контролем над голосом — «Свой текст» с включённой фоновой музыкой.
- Пробуете модель впервые — начните с «По описанию»: так быстрее понять, как Suno Speech строит подачу.
Текст для обоих режимов можно писать по-русски. В справке разработчика нет списка поддерживаемых языков, поэтому перед большой работой стоит сделать пробный запуск на коротком отрывке и послушать результат.
Настройки озвучки: подача, разнообразие, голос и фоновая музыка
В режиме «Свой текст» четыре настройки: «Подача», «Разнообразие», «Голос» и «Фоновая музыка», и именно они превращают синтез речи в озвучку с характером. Каждая отвечает за свою часть результата, поэтому их удобно разбирать по отдельности.
Подача. Свободное поле до 1000 символов, где словами описывается, как читать текст: интонация, темп, эмоция, акцент и характер музыки. Это главный рычаг, когда нужна нейросеть-озвучка с интонацией, а не ровное чтение. Хорошая подача отвечает на четыре вопроса: кто говорит, в каком настроении, с какой скоростью и что звучит фоном. Например: «Спокойная женщина-экскурсовод, тёплая интонация, неспешный темп, лёгкая фортепианная музыка».
Разнообразие. Определяет, насколько два варианта и разные запуски будут отличаться друг от друга. Уровней пять:
- «Точно по описанию» — модель держится ближе всего к вашей подаче.
- «Сбалансированно» — стоит по умолчанию, золотая середина.
- «Разные стили» — варианты заметнее расходятся по манере.
- «Смелые эксперименты» — модель свободнее трактует описание.
- «Максимально по-разному» — самый широкий разброс между вариантами.
Голос. Три значения: «Авто», «Женский» и «Мужской». При «Авто» пол голоса модель выбирает сама. Конкретного диктора по имени здесь нет — тембр и манеру вы задаёте словами в поле «Подача».
Фоновая музыка. Переключатель, по умолчанию выключен. Без музыки Suno Speech отдаёт чистую речь, с ним — озвучку с фоновой музыкой, где подложку модель подбирает по описанию из поля «Подача». Если нужна конкретная атмосфера, назовите её прямо: «лёгкий джаз», «тихий эмбиент», «торжественный оркестр».
Для начала подойдёт простая схема: голос задайте явно, разнообразие оставьте «Сбалансированно», музыку включите, а в подаче опишите персонажа и фон в одном-двух предложениях. Когда результат станет предсказуемым, пробуйте сдвигать разнообразие и уточнять подачу.
Сколько стоит Suno Speech и что приходит за один запрос
Suno Speech стоит 12 ₽ за запрос, и эта цена фиксированная: режим, длина текста и фоновая музыка на неё не влияют. Озвучка короткой фразы и сценария на 3000 символов обойдётся одинаково, поэтому выгоднее сразу вставлять текст целиком, а не дробить его на кусочки.
За один запрос приходят две дорожки — два варианта озвучки по одному и тому же тексту и описанию. В Студии они подписаны «Трек 1» и «Трек 2», у каждой свой плеер и своя кнопка скачивания. Сохраняются обе, так что можно спокойно сравнить варианты и выбрать тот, где интонация легла лучше, не запуская генерацию повторно.
Что это значит на практике:
- Цена не растёт от длины текста, поэтому длинный сценарий выгоднее одного короткого запуска на каждый абзац.
- Включённая фоновая музыка не добавляет к стоимости ни рубля.
- Два варианта в каждом запуске — это встроенный выбор, а не платная опция.
- Цену запроса видно в Студии ещё до запуска.
Оплата — в рублях через СБП, без подписки и без зарубежной карты. Пополняете баланс на нужную сумму и тратите его на любые модели каталога: сегодня Suno Speech, завтра генерация картинки или видео. Ежемесячного платежа нет, поэтому редкие запуски не превращаются в подписку, за которую платишь впустую.
Чтобы деньги не уходили на неудачные запуски, полезно начать с короткого пробного текста на две-три фразы. Так вы проверите подачу и голос, а длинный сценарий отправите уже с настройками, которые дали нужный результат.
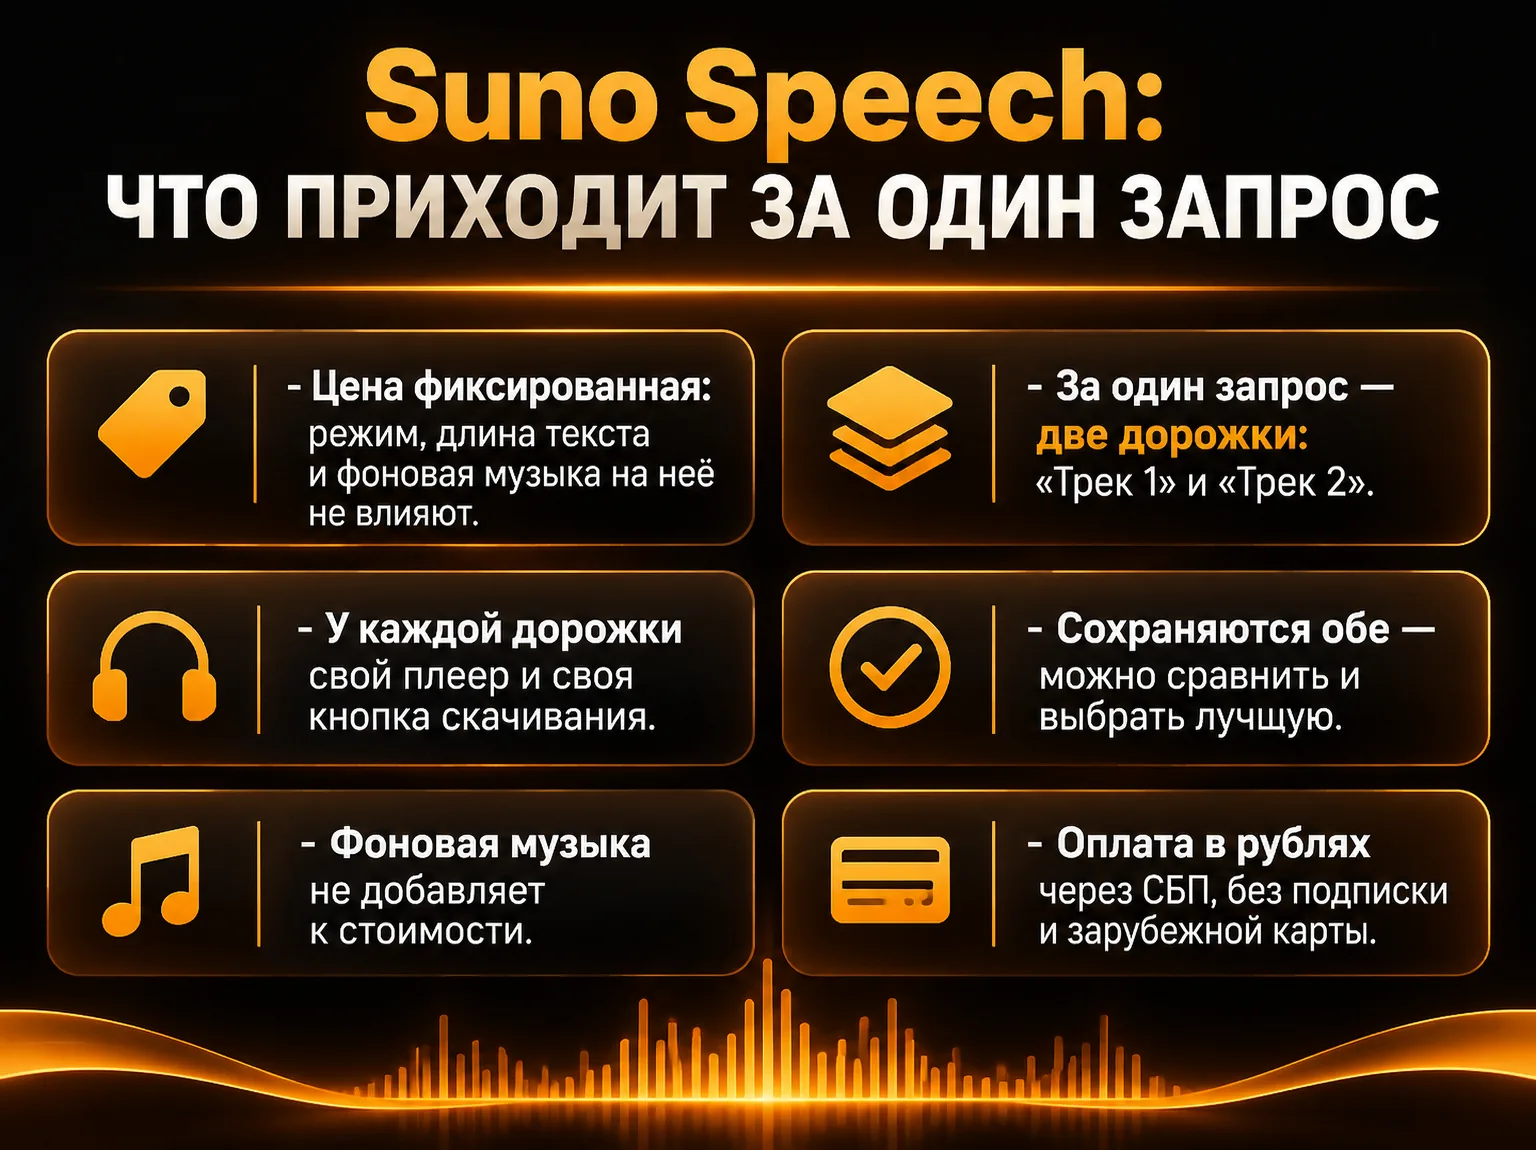
За один запрос Suno Speech отдаёт две дорожки, обе сохраняются
Готовый рецепт: озвучка текста с музыкой в стиле радиоэфира
Готовый рецепт — это режим «Свой текст», короткая реплика ведущего, подача радиоведущего с джазовой подложкой и включённая фоновая музыка. Этот пример сгенерирован 12 ноября 2026 года и дал две дорожки длиной 28,0 и 23,2 секунды.
Текст (поле сценария):
Добрый вечер! Вы слушаете вечерний выпуск. Сегодня расскажем, как за пару минут превратить обычный текст в живую озвучку с музыкой. Попробовать можно на искраген точка ру. Оставайтесь с нами — дальше будет интересно.
Подача:
Тёплый уверенный мужской голос радиоведущего, улыбка в голосе, спокойный темп, лёгкая джазовая подложка.
Настройки:
- Разнообразие — «Сбалансированно».
- Голос — «Мужской».
- Фоновая музыка — включена.
Обратите внимание, как написан текст. Адрес сайта записан словами — «искраген точка ру», а не латиницей с точкой: так меньше шансов, что модель прочитает его как набор букв. Предложения короткие, у каждого своя мысль, а восклицательный знак в начале задаёт приветственную интонацию.
Чтобы озвучка текста с музыкой получилась ровно такой, как задумано, держитесь нескольких правил:
- Пишите числа, адреса и аббревиатуры так, как их нужно произнести.
- Делите длинные предложения: в коротких фразах проще расставить интонацию.
- В подаче описывайте тон, темп, настроение и обстановку — именно для этого поле предназначено и в справке Suno.
- Называйте жанр музыки прямо и одним-двумя словами.
Этот рецепт легко переделать под свою задачу. Замените текст на анонс своего подкаста, а в подаче поменяйте «радиоведущего» на «рассказчика у костра» или «ведущую утреннего шоу» — в нашем примере около 30 слов уложились меньше чем в 30 секунд, это формат короткой заставки. Длительность дорожки модель выбирает сама, точной гарантии длины нет, поэтому для монтажа под конкретный хронометраж оставляйте запас.
Ограничения Suno Speech и когда взять другую нейросеть
Suno Speech задумана для коротких озвучек с настроением, и у неё есть ограничения, о части которых разработчик предупреждает сам. В анонсе Suno честно пишет, что британский акцент может «уехать в Австралию и обратно», а драматичные паузы иногда получаются слишком драматичными, — у Suno функция пока в статусе беты.
Чего в Suno Speech нет:
- Клонирования своего голоса — загрузить образец и озвучить им текст нельзя.
- Выбора конкретного голоса по имени — только «Авто», «Женский» или «Мужской» плюс описание в подаче.
- Разметки SSML и ручной расстановки ударений — интонацию задают словами.
- Текста длиннее 3000 символов за один запрос.
- Гарантии длительности — длину дорожки модель выбирает сама.
Из этого следует простое правило выбора. Suno Speech берите, когда нужна атмосфера: заставка, подводка, поздравление, сказка, медитация, короткий рекламный ролик, где фон так же важен, как голос. Две дорожки за запрос и музыка без доплаты делают такие задачи удобными и недорогими.
Если же нужна длинная ровная начитка — курс, аудиокнига, инструкция, — где важны точные ударения и одинаковый голос на десятках фрагментов, лучше подойдёт классический синтез речи. Как выбрать такую модель под ролик, курс или подкаст, мы разобрали в статье о нейросети для озвучки текста. А о том, как добиться живой речи без «робота» и что закон говорит о чужом голосе, — в материале о том, как создать голос нейросетью.
Часто удобно совмещать: основной текст начитать классической моделью, а вступление и концовку сделать в Suno Speech, где голос и музыка уже сведены. Так ролик звучит цельно, а длинная часть остаётся предсказуемой.
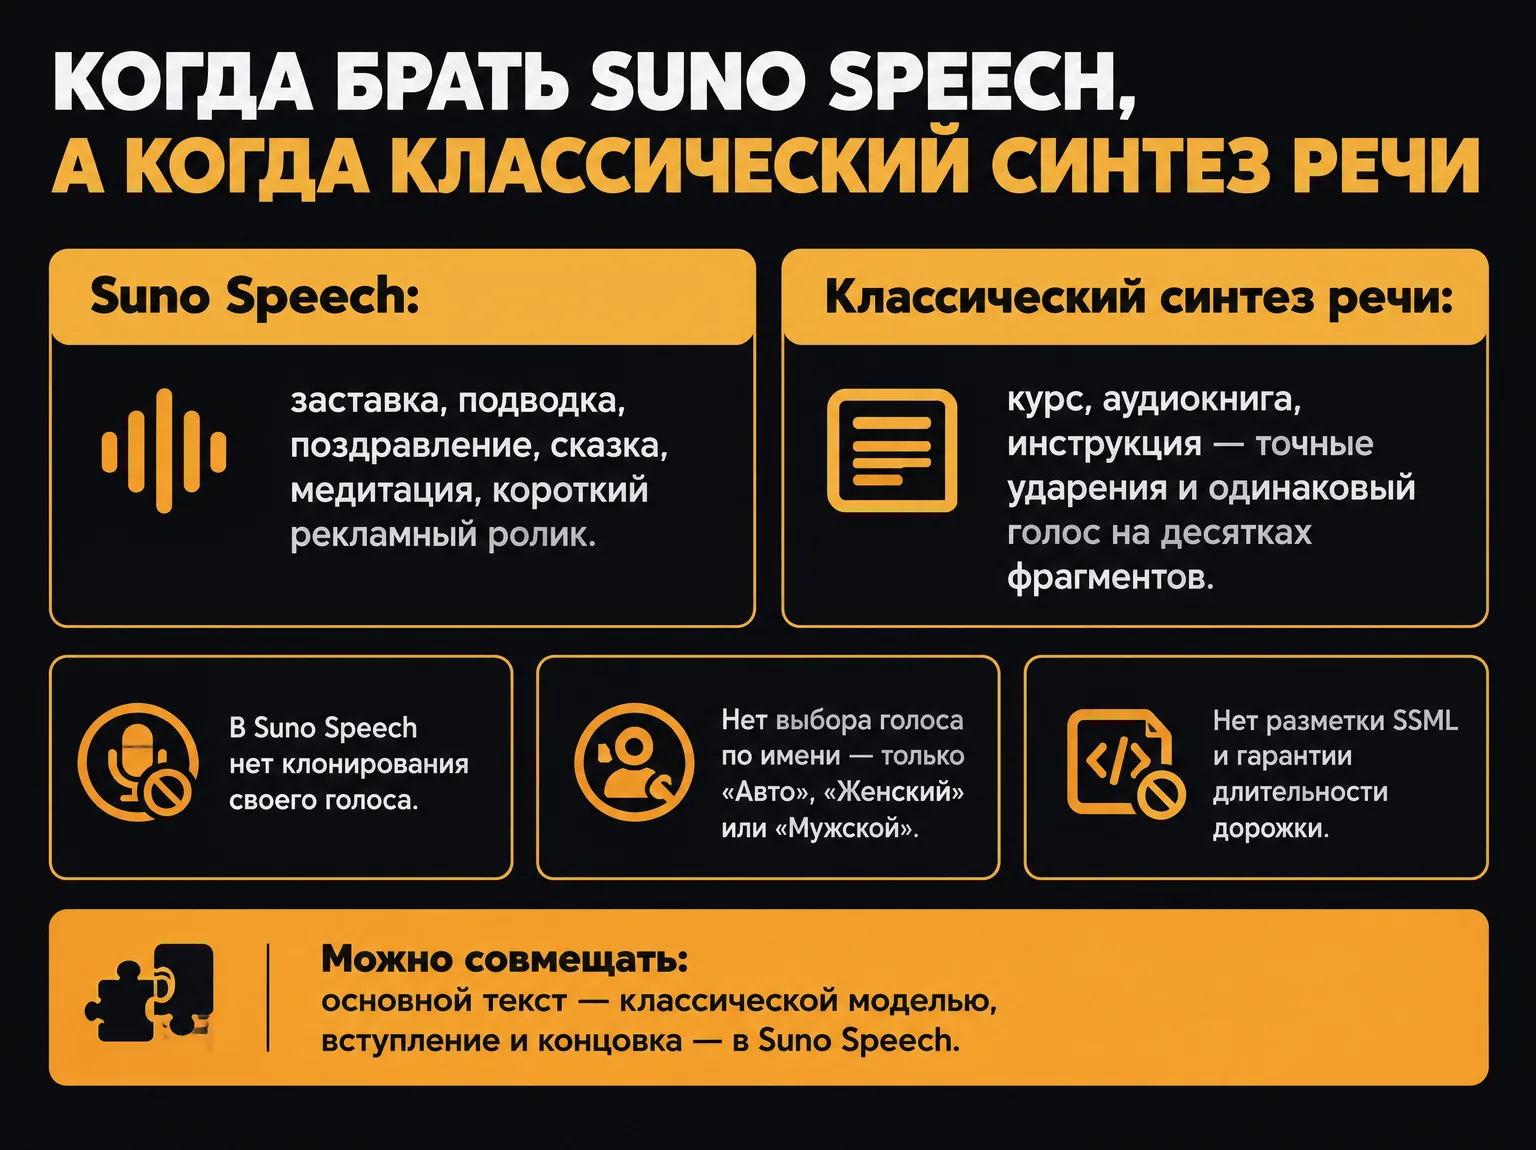
Suno Speech — для коротких озвучек с настроением, длинные начитки — классическому синтезу
Частые вопросы
Попробовать Suno Speech в IskraGen
Генерация без VPN, оплата в рублях через СБП. Первые генерации — за минуту.
100 ₽ в подарок при регистрации
Похожие статьи
Стили в суно: как задать жанр, вокал и настроение песни
20 сентября 2026 · 9 мин чтения
Suno AI на русском: как получить чистый вокал без акцента
20 сентября 2026 · 9 мин чтения
Суно не работает: почему падает генерация в Suno и что делать
20 сентября 2026 · 9 мин чтения
Промты для суно: промт для трека в Suno и 22 готовые строки
18 сентября 2026 · 11 мин чтения
Песня по тексту через нейросеть: как из своих слов сделать трек
4 сентября 2026 · 9 мин чтения