Видео из фото нейросетью: как собрать ролик из снимка
100 ₽ в подарок при регистрации
Промпт
Сцена: тёмное студийное пространство, глубокий почти чёрный фон #0A0A0F, боковая фиолетовая подсветка #7C3AFF, лёгкая объёмная дымка, мягкое зерно. Главный объект: одиночная фотография в тонкой светящейся рамке парит в центре кадра — снимок берега на рассвете; вправо от рамки тот же кадр раскладывается в ленту из четырёх последовательных кадров плёнки, и в каждом следующем волна продвигается дальше, а облака смещаются, будто модель достраивает движение. Детали: матовое стекло рамки, фиолетовые частицы вдоль ленты кадров, тонкие направляющие линии между кадрами, мягкие отражения на гладком тёмном полу, разница в положении воды и облаков от кадра к кадру. Композиция: 16:9, исходная фотография в левой трети, лента кадров уходит вправо, широкое негативное пространство сверху, ракурс на уровне глаз, контрастный мягкий свет, неглубокая глубина резкости. Ограничения: absolutely NO text, NO letters, NO numbers, NO logos, NO brand marks, NO watermarks; никаких эмблем сервисов; узнаваемых лиц крупным планом не показывать. Назначение: обложка статьи блога о генерации видео из фотографии. Стиль: тёмный фон #0A0A0F, акцентный фиолетовый #7C3AFF, крупный рубленый шрифт, без водяных знаков.
Главное:
- Видео из фото нейросетью — не движущийся снимок: модель дорисовывает новые кадры, а фото становится первым из них.
- В IskraGen ролик из одного фото длится от 3 до 30 секунд; дольше 15 секунд бывает только у Grok Imagine.
- Лучше оживают крупный портрет, предмет на чистом фоне и пейзаж; тёмный, размытый или обрезанный кадр ломает ролик.
- Grok Imagine Image to Video на 6 секунд в 480p стоит 15 ₽, Kling 2.6 Image to Video без звука — 50 ₽.
- Чаще всего плывут лица, руки и надписи на товаре: сначала проверьте снимок одним коротким запуском.
Запрос «видео из фото нейросеть» набирают больше 13 тысяч раз в месяц, и почти половина уточняет, как обойтись без оплаты. За цифрой стоят два разных человека. Один хочет, чтобы старая фотография ожила — заморгала, повернула голову, поймала ветер в волосах. Второй собирает ролик под задачу: карточку товара, поздравление, обложку для соцсети. Видео из фото нейросетью делается в обоих случаях, но снимок, промпт и модель нужны разные. Дальше — что именно происходит с вашим кадром, какой оригинал не сработает, где модели ошибаются и сколько стоит запуск в рублях.
Что происходит, когда вы делаете видео из фото нейросетью
Модель не анимирует ваш снимок, а генерирует новые кадры, для которых он служит первым. Это не движущаяся фотография, а короткая сцена, построенная вокруг неё.
Внутри процесс распадается на три шага. Сначала модель разбирает сцену: находит человека, предметы, фон, оценивает глубину пространства и направление света. Потом решает, что должно двигаться, — по самому кадру и по вашему текстовому описанию. И только затем собирает последовательность промежуточных кадров, стараясь сохранить визуальную связность с исходником.
Отсюда вытекает главное следствие: результат каждый раз новый. Тот же снимок и тот же промпт дадут два похожих, но не одинаковых ролика. Это не сбой, а свойство генерации — модель заново достраивает движение, а не воспроизводит записанный сценарий.
Второе следствие касается длительности. Видео из фото нейросетью живёт короткими отрезками: практика сходится на 4–8 секундах с внятной динамикой. Дальше модели не хватает опоры — единственный кадр перестаёт удерживать сцену, и она начинает уходить от оригинала.
Третье — узнаваемость. Чем крупнее и чётче объект на входе, тем дольше он остаётся собой. Мелкое лицо в углу кадра модель «дорисовывает» по своим представлениям, и через две секунды человек на видео уже не тот, что на фото.
В каталоге IskraGen этот режим называется image-to-video и вынесен в отдельные карточки моделей: Hailuo Standard Image to Video, Kling 2.6 Image to Video, Kling O3 — Картинка в видео. Вы загружаете снимок, описываете движение словами, выбираете формат — и получаете готовый ролик. Соседний сценарий, когда оживает именно портрет, мы разобрали подробно в статье как оживить фото нейросетью.
Какой снимок оживёт, а какой сломает ролик
Хорошо работают четыре типа кадров: портрет с чётко видимым лицом, предмет на чистом фоне, интерьер с глубиной и пейзаж с небом, водой или деревьями. Общее у них — понятный центр и место, куда двигаться.
Пейзаж выигрывает потому, что в нём уже заложено естественное движение: облака плывут, вода идёт рябью, листва качается. Модели достаточно продолжить то, что глаз и так достраивает. Портрет работает по другой причине — лицо крупное, границы объекта читаются, и модель не путает его с фоном.
Плохо заходят четыре вещи. Слишком тёмные снимки: в тенях нет деталей, и модель заполняет их шумом. Кадры с размытием — генератор принимает смаз за форму объекта и растягивает его. Объекты, обрезанные краем кадра: продолжения нет, и модель дорисовывает его наугад. И перегруженные коллажи без понятного центра — сцена рассыпается на несогласованные куски.
Отдельная зона риска — руки и надписи. Пальцы у видеомоделей ломаются чаще всего, поэтому руки лучше не ставить в центр кадра и не просить активной мелкой моторики: «руки спокойно лежат» надёжнее, чем «перебирает струны». Текст в кадре часто не переживает движения: логотип, ценник или вывеска плывут, поэтому титры добавляют потом, на монтаже. Что об этом заявляют сами разработчики, — в разделе об ограничениях ниже.
Подготовка занимает минуту и экономит генерацию. Кадрируйте снимок под тот формат, в котором нужен ролик, — 16:9 для горизонтального, 9:16 для вертикального. Берите оригинал, а не пересланный через мессенджер файл: сжатие съедает детали, а модель принимает артефакты компрессии за фактуру. Если фото старое или мутное, сначала приведите его в порядок, а потом отправляйте в генерацию.
Проверить кадр одним запуском надёжнее, чем гадать. Короткое видео из фото нейросетью в низком разрешении сразу показывает, держит ли снимок движение: если лицо поплыло уже на второй секунде, дело в оригинале, а не в формулировке промпта.
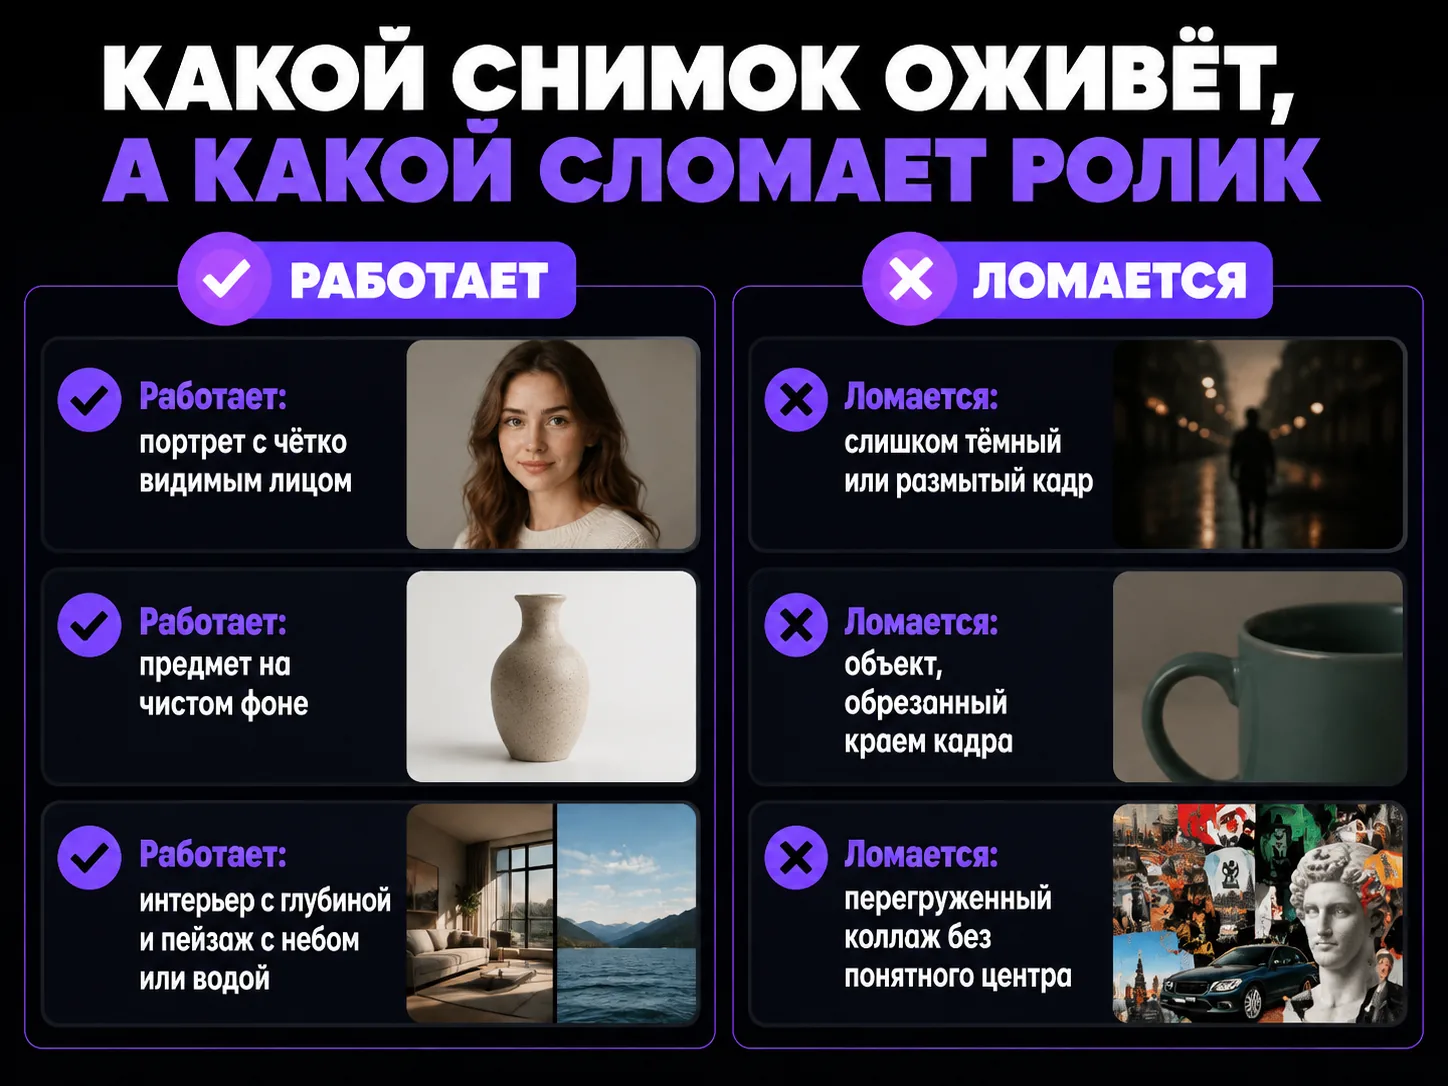
Что определяет результат ещё до промпта — сгенерировано в IskraGen
Чем сделать видео из фото нейросетью: модели и цены
Модель определяет три вещи: сколько секунд длится ролик, есть ли в нём звук и сколько стоит один запуск.
В таблице — параметры, с которыми видео из фото нейросетью можно сделать в Студии IskraGen, и цена одного запуска при этих параметрах. Ссылка в колонке «Источник» ведёт на страницу разработчика модели.
| Модель и режим | Источник | Длительность | Разрешение | Звук | Полная цена примера | Проверено |
|---|---|---|---|---|---|---|
| Hailuo Standard Image to Video | MiniMax | 6 или 10 с | 768p | нет | 6 с — 28 ₽; 10 с — 67,20 ₽ | 09.11.2026 |
| Kling — V2.5 Turbo Image to Video Pro | Kling AI | 5 или 10 с | 1080p | нет | 5 с — 55 ₽; 10 с — 110 ₽ | 09.11.2026 |
| Kling 2.6 Image to Video | Kling AI | 5 или 10 с | 1080p | по выбору | 5 с без звука — 50 ₽; 10 с со звуком — 200 ₽ | 09.11.2026 |
| Kling O3 — Картинка в видео | Kling AI | 3–15 с | 1080p | есть | 3 с — 114 ₽; 15 с — 570 ₽ | 09.11.2026 |
| Seedance 2 | ByteDance Seed | 4–15 с | 480p, 720p, 1080p, 4K | по выбору | 4 с, 480p — 80 ₽; 15 с, 4K — 3000 ₽ | 09.11.2026 |
| MiniMax H3 — Картинка в видео | MiniMax | 4–15 с | 768P или 2K | не выбирается | 4 с, 768P — 32 ₽; дальше посекундно, 2K — ×1,625 | 09.11.2026 |
| Grok Imagine Image to Video | xAI | 6, 10, 20 или 30 с | 480p, 720p, 1080p | не выбирается | 6 с, 480p — 15 ₽; 30 с, 1080p — 240 ₽ | 09.11.2026 |
Условия и цены проверены 09.11.2026.
Наш тест: 27 роликов
Чтобы проверить, как видео из фото нейросетью выходит на практике, 9 ноября 2026 года мы сняли 27 роликов в трёх моделях из таблицы: портрет, флакон духов и вертикальная реклама кофе, по три попытки на пару. Ролики оценивал вслепую ИИ-агент по правилу, записанному до запуска. Неудачи оплачены и показаны наравне с удачами. Портрет оживили все три модели, а с товаром и рекламой они ошибались по-разному: Grok Imagine не сохранил форму флакона ни разу, MiniMax H3 перерисовывал кофе.
| Модель | Пригодных | ₽ за пригодный ролик |
|---|---|---|
| Kling 2.6 Image to Video | 7 из 9 роликов | 64,29 ₽ |
| MiniMax H3 — Картинка в видео | 6 из 9 роликов | 60,00 ₽ |
| Grok Imagine Image to Video | 6 из 9 роликов | 45,00 ₽ |
Kling 2.6, портрет, 5 с без звука — пригодный ролик из теста
Grok Imagine, флакон, 6 с в 720p — непригодный ролик: облёт есть, но форма флакона и подставка изменились
Все 27 роликов с исходниками, промптами, оценками и расходами — в исследовании «Нейросеть для генерации видео из фото: тест 27 роликов».
Длительность, разрешение и звук в таблице — это то, что продаётся в IskraGen. У разработчиков возможности бывают шире: MiniMax, например, выпускает Hailuo 02 ещё и в 1080p на 6 секунд, а в Студии Hailuo Standard работает в 768p. У Seedance 2 цена указана без видео-референса: загруженное видео тоже тарифицируется.
Цена списывается за каждый запуск, а не за месяц подписки, и зависит от выбранных параметров. У Kling O3, Seedance 2 и MiniMax H3 она растёт посекундно, у Grok Imagine — по длительности и разрешению, у Kling 2.6 — ещё и от звука. Оплата российской картой, без зарубежных сервисов и VPN.
Со звуком разница между моделями заметнее всего. У Kling 2.5 Turbo нативного звука нет: одновременную генерацию картинки и звука Kuaishou представила с версией 2.6. Голос Kling 2.6, по руководству разработчика, говорит только по-китайски и по-английски, а реплики на других языках модель переводит на английский. MiniMax заявляет у H3 стереозвук, xAI — генерацию звука у Grok Imagine, но отдельного переключателя звука у этих двух моделей в Студии нет.
Если героев или референсов несколько, выбор сужается. Seedance 2, по данным ByteDance, принимает в качестве референсов до 9 изображений, 3 видео и 3 аудиофрагментов. В Kling O3 героя задают элементом из 2–4 фото — так элементы описывает Kuaishou.
Платить приходится за каждую попытку, а не только за удачную. Видео из фото нейросетью редко получается с первого запуска, поэтому идею проверяют на коротком ролике в низком разрешении, а длинный и чистовой запуск делают потом. Разбор всей линейки видеомоделей — в обзоре лучших нейросетей для генерации видео.
Промпт для движения: формула, которая держит кадр
Рабочий промпт собирается по формуле: объект, действие, окружение, свет, камера. Пять слотов, каждый закрывается одной короткой фразой, без литературы.
Промпт для видео из фото нейросетью отличается от промпта для картинки одним: здесь описывают не сцену, а изменение. Статичное «красивая девушка в кафе» модель уже видит на входе — ей нужно знать, что именно должно поменяться за эти пять секунд.
Слабое место новичка — попытка уложить в пять секунд целый сюжет. «Девушка оборачивается, улыбается, идёт к окну, за окном закат» — это четыре действия, и модель смешает их в кашу. Одно, максимум два действия на клип; длинную сцену режут на несколько генераций и склеивают на монтаже.
Камеру нужно называть прямо. Без указания модель выбирает хаотичный дрейф и добавляет дрожание, которого вы не просили. В конец промпта дописывают «камера статична», «медленный наезд» или «плавная панорама» — одну траекторию на сцену, не две сразу.
Амплитуда движения — второй регулятор. Морфинг, когда предметы плывут и меняют форму, лечится уменьшением размаха: поворот головы на 30 градусов вместо 180, шаг вместо пробежки, «медленно наливает» вместо «наливает». Модель тем стабильнее, чем меньше ей приходится придумывать.
Действие подбирают под длину клипа. Если человек должен встать, подойти к двери и открыть её, а ролик длится пять секунд, движение оборвётся на середине. Либо берите модель с более длинным форматом, либо оставляйте одно короткое действие, которое успевает завершиться.
Пример рабочего промпта для портрета: «Женщина на фото, лёгкая улыбка и медленный поворот головы вправо, кафе с размытым фоном, мягкий вечерний свет из окна, камера статична». Пример для предмета: «Керамическая кружка на столе, от кофе поднимается пар, кухня утром, тёплый боковой свет, очень медленный наезд». Оба укладываются в один слот действия и не трогают руки.
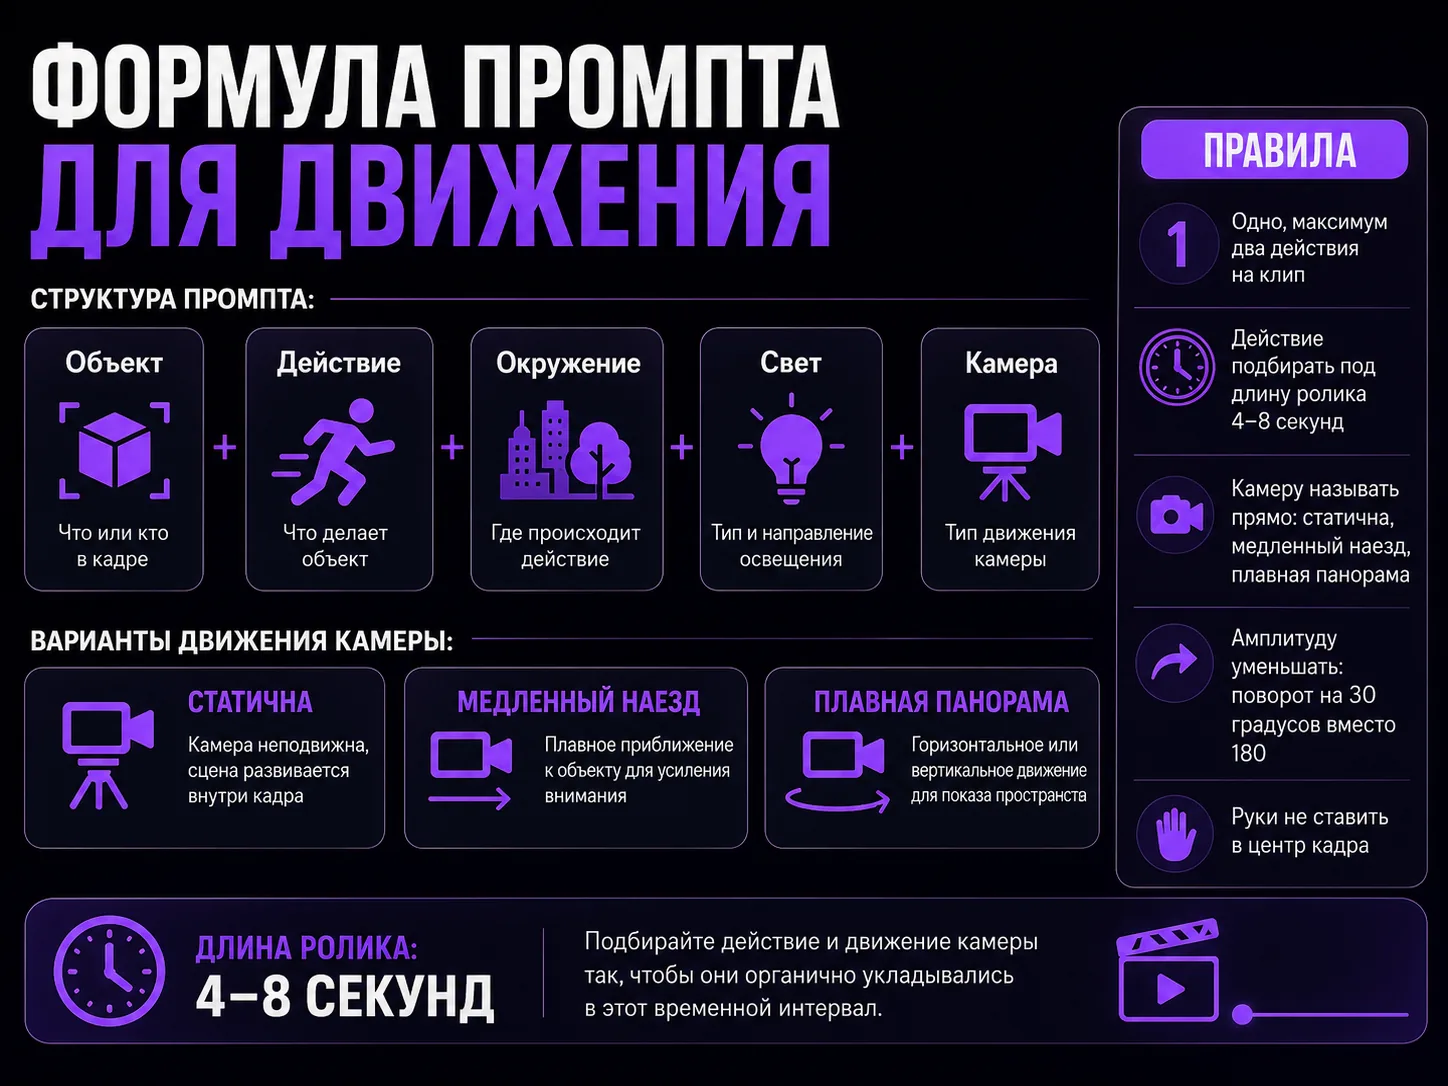
Пять слотов промпта, которые держат кадр — сгенерировано в IskraGen
Ограничения: требования к фото, лицо, товар и неудачные запуски
Видео из фото нейросетью упирается в ограничения ещё до промпта: у каждой модели свои требования к снимку, и не все разработчики их публикуют.
Требования к фото. MiniMax в документации API для Hailuo 02 указывает: JPG, JPEG, PNG или WebP, файл меньше 20 МБ, короткая сторона больше 300 пикселей, соотношение сторон от 2:5 до 5:2. Kuaishou в руководствах по Kling 2.6 и 3.0 лимитов на файл не приводит. xAI в описании image-to-video для Grok Imagine формат и размер снимка тоже не заявляет. В самой Студии IskraGen снимок для Hailuo Standard, Kling 2.5 Turbo, Kling 2.6 и Kling O3 принимается размером до 20 МБ, для Grok Imagine — в JPEG, PNG или WebP до 10 МБ.
Движение. Kuaishou в руководстве по image-to-video прямо пишет, что сложные физические движения модели пока даются с трудом, и советует описывать движение, которое правдоподобно для этого снимка. На практике чаще всего ломаются быстрые жесты, бег, разворот на месте и всё, где руки берут или перекладывают предметы.
Лицо. Чем длиннее ролик и сильнее движение, тем дальше лицо уходит от оригинала: черты усредняются, меняется форма глаз и улыбки. Если видео из фото нейросетью ломается в одном и том же месте при разных промптах, причина обычно в исходном снимке, а не в формулировке.
Товар, логотип и надписи. С товаром то же самое происходит с мелкими деталями — логотипом, надписью на упаковке, ценником. Разработчики оценивают это по-разному. Для Kling 3.0 Kuaishou заявляет, что модель распознаёт текст на загруженном изображении — вывески, подписи, логотипы — и старается не сдвигать и не размывать его. ByteDance в анонсе Seedance 2.0, наоборот, сама называет точность отрисовки текста местом, где модели есть куда расти. Обещание разработчика не гарантирует результат в конкретном кадре, поэтому логотип и надпись проверяют в каждом ролике.
Типичные неудачи и что с ними делать:
- Лицо поплыло на второй секунде — возьмите снимок, где лицо крупнее, и допишите «камера статична».
- Предмет меняет форму — уменьшите амплитуду: «медленно поворачивается» вместо «вращается».
- Действие обрывается на середине — оставьте одно короткое действие или выберите модель с длинным роликом.
- Логотип или надпись расплываются — уберите текст из исходника и добавьте его поверх ролика на монтаже.
- Голос в ролике звучит не по-русски — у Kling 2.6 это ожидаемо, русскую озвучку делают отдельной дорожкой.
Слайдшоу с музыкой или генерация из одного кадра
Это два разных инструмента, и путаница между ними стоит людям денег. Слайдшоу показывает ваши снимки по очереди, генерация достраивает новое движение вокруг одного кадра.
Слайдшоу полностью предсказуемо: вы выбираете фотографии, порядок, переходы и трек, а программа собирает их в ролик. Содержание кадров не меняется — меняется только подача. Для семейной подборки, поздравления или отчёта о поездке это правильный выбор, и нейросеть тут не нужна вовсе.
Генерация даёт эффект, которого в слайдшоу не бывает: снимок оживает, камера входит в сцену, появляется глубина. Плата за это — непредсказуемость. Результат отличается от исходника, каждая генерация своя, и часть попыток уходит в корзину. Поэтому сделать видео из фото нейросетью разумно сначала на простой модели, а флагман включать, когда кадр и промпт уже проверены.
Разница видна и в бюджете. Слайдшоу собирается из десятка снимков за один проход, а генерация считается поштучно: каждый ролик — отдельный запуск со своей ценой.
Между этими полюсами есть третий сценарий — серия планов с одним героем. Здесь помогает Kling O3 — Картинка в видео: элемент из 2–4 фото героя удерживает его внешность, а на выходе получается не один кадр с движением, а связка сцен. Дальше их монтируют в общий ролик.
Звук решается по-другому. Kling 2.6 генерирует дорожку вместе с картинкой, и для короткого ролика с репликой на английском или фоновыми звуками этого достаточно. Если нужна музыка под настроение или закадровый голос на русском, дорожку собирают отдельно и накладывают на монтаже — так контроля больше, а перегенераций меньше.
Видео из фото нейросетью проверяют на короткой модели и одном кадре. Когда стало понятно, что снимок держит движение, а промпт не разваливает сцену, тот же кадр отправляют на Kling 2.6 или Kling O3 — и получают чистый ролик за меньшее число попыток.
Частые вопросы
Попробовать Kling 2.6 Image to Video в IskraGen
Генерация без VPN, оплата в рублях через СБП. Первые генерации — за минуту.
100 ₽ в подарок при регистрации
Похожие статьи
Нейросеть для генерации видео из фото: тест 27 роликов
9 ноября 2026 · 18 мин чтения

Как оживить фото нейросетью: от снимка до видео за пять минут
15 августа 2026 · 8 мин чтения
Улучшить качество видео нейросетью: Video Upscale до 1080p, 2K и 4K
14 ноября 2026 · 9 мин чтения
Генерация видео без подписки: где платить в рублях, 5 площадок
9 ноября 2026 · 16 мин чтения
Нейросеть Дед Мороз: голос, говорящее видео по фото и песня
3 ноября 2026 · 9 мин чтения